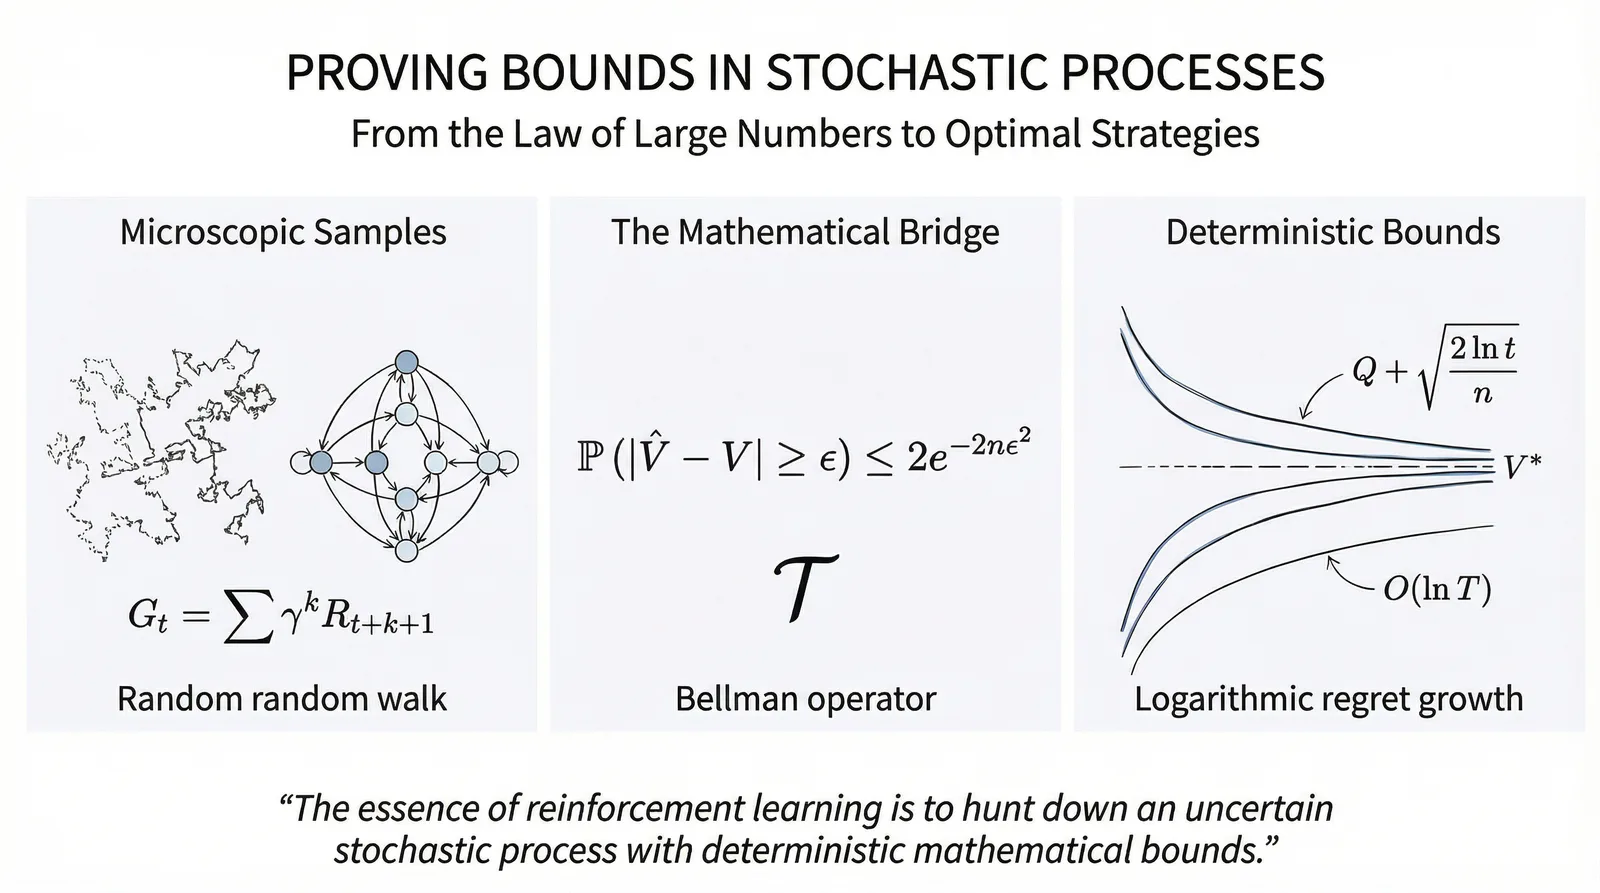
The essence of reinforcement learning is to hunt down an uncertain stochastic process with deterministic mathematical bounds. All our efforts are to make these bounds ever tighter.
“Chance is only the measure of our ignorance.” — Henri Poincaré
这篇笔记想回答一个问题:在随机环境里做序列决策,什么时候能给出确定的保证?如果环境模型已知,贝尔曼算子是一个压缩映射,价值迭代一定收敛。环境未知时,我们只能用有限样本估计期望,这时需要集中不等式告诉我们估计离真值有多远。沿着这条线,可以从 MDP 一路推到 UCB 和时序差分学习。
The mechanical foundation of sequential decision-making: MDP (Markov Decision Process)
先把决策问题形式化。设状态空间为 S \mathcal{S} S A \mathcal{A} A t t t S t ∈ S S_t \in \mathcal{S} S t ∈ S A t ∈ A A_t \in \mathcal{A} A t ∈ A P ( s ′ ∣ s , a ) P(s' \mid s, a) P ( s ′ ∣ s , a ) s s s a a a
马尔可夫决策过程(MDP)依赖马尔可夫性:未来只取决于当前状态和动作,与更早的历史无关:
P ( S t + 1 ∣ S t , A t , … , S 0 , A 0 ) = P ( S t + 1 ∣ S t , A t ) \begin{equation}
\mathbb{P}(S_{t+1} \mid S_t, A_t, \dots, S_0, A_0) = \mathbb{P}(S_{t+1} \mid S_t, A_t)
\end{equation} P ( S t + 1 ∣ S t , A t , … , S 0 , A 0 ) = P ( S t + 1 ∣ S t , A t ) 也就是说,S t S_t S t
为了衡量好坏,引入奖励 R ( s , a ) R(s, a) R ( s , a ) V π ( s ) V^\pi(s) V π ( s ) γ ∈ [ 0 , 1 ) \gamma \in [0, 1) γ ∈ [ 0 , 1 )
贝尔曼方程
确定 MDP 之后,目标是找到最优策略 π ∗ \pi^* π ∗
V π ( s ) = ∑ a ∈ A π ( a ∣ s ) [ R ( s , a ) + γ ∑ s ′ ∈ S P ( s ′ ∣ s , a ) V π ( s ′ ) ] \begin{equation}
V^\pi(s) = \sum_{a \in \mathcal{A}} \pi(a|s) \left[ R(s, a) + \gamma \sum_{s' \in \mathcal{S}} P(s' \mid s, a) V^\pi(s') \right]
\end{equation} V π ( s ) = a ∈ A ∑ π ( a ∣ s ) [ R ( s , a ) + γ s ′ ∈ S ∑ P ( s ′ ∣ s , a ) V π ( s ′ ) ] 这个方程把对无穷长轨迹的求和,变成了一步之内的关系。把右边看成作用在价值函数上的算子 T π : R ∣ S ∣ → R ∣ S ∣ \mathcal{T}^\pi: \mathbb{R}^{|\mathcal{S}|} \to \mathbb{R}^{|\mathcal{S}|} T π : R ∣ S ∣ → R ∣ S ∣ V π V^\pi V π
Complete Metric Spaces and Bellman Operators
记 V \mathcal{V} V S \mathcal{S} S
d ( V , U ) = ∥ V − U ∥ ∞ = max s ∈ S ∣ V ( s ) − U ( s ) ∣ \begin{equation}
d(V, U) = \|V - U\|_\infty = \max_{s \in \mathcal{S}} |V(s) - U(s)|
\end{equation} d ( V , U ) = ∥ V − U ∥ ∞ = s ∈ S max ∣ V ( s ) − U ( s ) ∣ ( V , ∥ ⋅ ∥ ∞ ) (\mathcal{V}, \|\cdot\|_\infty) ( V , ∥ ⋅ ∥ ∞ ) T ∗ : V → V \mathcal{T}^*: \mathcal{V} \to \mathcal{V} T ∗ : V → V
( T ∗ V ) ( s ) = max a ∈ A [ R ( s , a ) + γ ∑ s ′ ∈ S P ( s ′ ∣ s , a ) V ( s ′ ) ] \begin{equation}
(\mathcal{T}^* V)(s) = \max_{a \in \mathcal{A}} \left[ R(s, a) + \gamma \sum_{s' \in \mathcal{S}} P(s' \mid s, a) V(s') \right]
\end{equation} ( T ∗ V ) ( s ) = a ∈ A max [ R ( s , a ) + γ s ′ ∈ S ∑ P ( s ′ ∣ s , a ) V ( s ′ ) ] 压缩映射
要证明反复应用 T ∗ \mathcal{T}^* T ∗ V , U ∈ V V, U \in \mathcal{V} V , U ∈ V
∥ T ∗ V − T ∗ U ∥ ∞ ≤ γ ∥ V − U ∥ ∞ , γ < 1 \begin{equation}
\|\mathcal{T}^* V - \mathcal{T}^* U\|_\infty \le \gamma \|V - U\|_\infty, \quad \gamma < 1
\end{equation} ∥ T ∗ V − T ∗ U ∥ ∞ ≤ γ ∥ V − U ∥ ∞ , γ < 1 证明:任取状态 s s s ( T ∗ V ) ( s ) ≥ ( T ∗ U ) ( s ) (\mathcal{T}^* V)(s) \ge (\mathcal{T}^* U)(s) ( T ∗ V ) ( s ) ≥ ( T ∗ U ) ( s ) a ∗ a^* a ∗ V V V s s s a ∗ = arg max a [ R s , a + γ E [ V ′ ] ] a^* = \arg\max_a [R_{s,a} + \gamma \mathbb{E}[V'] ] a ∗ = arg max a [ R s , a + γ E [ V ′ ]] a ∗ a^* a ∗
( T ∗ V ) ( s ) − ( T ∗ U ) ( s ) = max a [ R s , a + γ E [ V ′ ] ] − max a [ R s , a + γ E [ U ′ ] ] ≤ [ R s , a ∗ + γ E [ V ′ ] ] − [ R s , a ∗ + γ E [ U ′ ] ] = γ ∑ s ′ ∈ S P ( s ′ ∣ s , a ∗ ) ( V ( s ′ ) − U ( s ′ ) ) ≤ γ ∑ s ′ ∈ S P ( s ′ ∣ s , a ∗ ) ∣ V ( s ′ ) − U ( s ′ ) ∣ ≤ γ ∑ s ′ ∈ S P ( s ′ ∣ s , a ∗ ) ∥ V − U ∥ ∞ = γ ∥ V − U ∥ ∞ \begin{equation}
\begin{aligned}
(\mathcal{T}^* V)(s) - (\mathcal{T}^* U)(s) &= \max_a [R_{s,a} + \gamma \mathbb{E}[V'] ] - \max_a [R_{s,a} + \gamma \mathbb{E}[U'] ] \\
&\le [R_{s,a^*} + \gamma \mathbb{E}[V'] ] - [R_{s,a^*} + \gamma \mathbb{E}[U'] ] \\
&= \gamma \sum_{s' \in \mathcal{S}} P(s' \mid s, a^*) (V(s') - U(s')) \\
&\le \gamma \sum_{s' \in \mathcal{S}} P(s' \mid s, a^*) |V(s') - U(s')| \\
&\le \gamma \sum_{s' \in \mathcal{S}} P(s' \mid s, a^*) \|V - U\|_\infty \\
&= \gamma \|V - U\|_\infty
\end{aligned}
\end{equation} ( T ∗ V ) ( s ) − ( T ∗ U ) ( s ) = a max [ R s , a + γ E [ V ′ ]] − a max [ R s , a + γ E [ U ′ ]] ≤ [ R s , a ∗ + γ E [ V ′ ]] − [ R s , a ∗ + γ E [ U ′ ]] = γ s ′ ∈ S ∑ P ( s ′ ∣ s , a ∗ ) ( V ( s ′ ) − U ( s ′ )) ≤ γ s ′ ∈ S ∑ P ( s ′ ∣ s , a ∗ ) ∣ V ( s ′ ) − U ( s ′ ) ∣ ≤ γ s ′ ∈ S ∑ P ( s ′ ∣ s , a ∗ ) ∥ V − U ∥ ∞ = γ ∥ V − U ∥ ∞ 这对所有状态都成立,所以 ∥ T ∗ V − T ∗ U ∥ ∞ ≤ γ ∥ V − U ∥ ∞ \|\mathcal{T}^* V - \mathcal{T}^* U\|_\infty \le \gamma \|V - U\|_\infty ∥ T ∗ V − T ∗ U ∥ ∞ ≤ γ ∥ V − U ∥ ∞ T ∗ \mathcal{T}^* T ∗ γ \gamma γ max \max max T π \mathcal{T}^\pi T π
由巴拿赫不动点定理,压缩映射在完备空间中有唯一不动点,而且从任意初值 V 0 V_0 V 0 γ k \gamma^k γ k T π \mathcal{T}^\pi T π V π V^\pi V π T ∗ \mathcal{T}^* T ∗ V ∗ V^* V ∗ T ∗ \mathcal{T}^* T ∗
从精确算子到采样估计
问题在于,强化学习中转移核 P P P R R R τ = { s 0 , a 0 , r 1 , s 1 , … } \tau = \{s_0, a_0, r_1, s_1, \dots\} τ = { s 0 , a 0 , r 1 , s 1 , … } V ^ ( s ) \hat{V}(s) V ^ ( s ) G t G_t G t
这就引出下一个问题:给定有限样本,V ^ ( s ) \hat{V}(s) V ^ ( s )
From rectangular scaling to Chebyshev
我们观测不到算子里的期望 E \mathbb{E} E μ ^ n \hat{\mu}_n μ ^ n n n n ϵ \epsilon ϵ
马尔可夫不等式:只用均值
如果只知道随机变量的均值,对它的波动能说什么?对非负随机变量 X ≥ 0 X \ge 0 X ≥ 0 a > 0 a > 0 a > 0
P ( X ≥ a ) ≤ E [ X ] a \begin{equation}
\mathbb{P}(X \ge a) \le \frac{\mathbb{E}[X]}{a}
\end{equation} P ( X ≥ a ) ≤ a E [ X ] 证明:考虑指示函数 I X ≥ a \mathbb{I}_{X \ge a} I X ≥ a X ≥ a X \ge a X ≥ a X a ≥ 1 = I X ≥ a \frac{X}{a} \ge 1 = \mathbb{I}_{X \ge a} a X ≥ 1 = I X ≥ a X < a X < a X < a X a ≥ 0 = I X ≥ a \frac{X}{a} \ge 0 = \mathbb{I}_{X \ge a} a X ≥ 0 = I X ≥ a I X ≥ a ≤ X a \mathbb{I}_{X \ge a} \le \frac{X}{a} I X ≥ a ≤ a X
E [ I X ≥ a ] ≤ E [ X a ] ⟹ P ( X ≥ a ) ≤ E [ X ] a \begin{equation}
\mathbb{E}[\mathbb{I}_{X \ge a}] \le \mathbb{E}\left[\frac{X}{a}\right] \implies \mathbb{P}(X \ge a) \le \frac{\mathbb{E}[X]}{a}
\end{equation} E [ I X ≥ a ] ≤ E [ a X ] ⟹ P ( X ≥ a ) ≤ a E [ X ] 这个界很松,尾部概率只按 1 / a 1/a 1/ a
切比雪夫不等式:加入方差
如果还知道方差 σ 2 \sigma^2 σ 2 X X X μ \mu μ σ 2 \sigma^2 σ 2 ϵ > 0 \epsilon > 0 ϵ > 0
P ( ∣ X − μ ∣ ≥ ϵ ) ≤ σ 2 ϵ 2 \begin{equation}
\mathbb{P}(|X - \mu| \ge \epsilon) \le \frac{\sigma^2}{\epsilon^2}
\end{equation} P ( ∣ X − μ ∣ ≥ ϵ ) ≤ ϵ 2 σ 2 证明:事件 { ∣ X − μ ∣ ≥ ϵ } \{|X - \mu| \ge \epsilon\} { ∣ X − μ ∣ ≥ ϵ } ( X − μ ) 2 ≥ ϵ 2 (X - \mu)^2 \ge \epsilon^2 ( X − μ ) 2 ≥ ϵ 2 ( X − μ ) 2 (X - \mu)^2 ( X − μ ) 2
P ( ( X − μ ) 2 ≥ ϵ 2 ) ≤ E [ ( X − μ ) 2 ] ϵ 2 \begin{equation}
\mathbb{P}((X - \mu)^2 \ge \epsilon^2) \le \frac{\mathbb{E}[(X - \mu)^2]}{\epsilon^2}
\end{equation} P (( X − μ ) 2 ≥ ϵ 2 ) ≤ ϵ 2 E [( X − μ ) 2 ] 由方差的定义 E [ ( X − μ ) 2 ] = σ 2 \mathbb{E}[(X - \mu)^2] = \sigma^2 E [( X − μ ) 2 ] = σ 2
P ( ∣ X − μ ∣ ≥ ϵ ) ≤ σ 2 ϵ 2 \begin{equation}
\mathbb{P}(|X - \mu| \ge \epsilon) \le \frac{\sigma^2}{\epsilon^2}
\end{equation} P ( ∣ X − μ ∣ ≥ ϵ ) ≤ ϵ 2 σ 2 尾部概率现在按 1 / ϵ 2 1/\epsilon^2 1/ ϵ 2
但这仍然不够快。对 n n n X ˉ n \bar{X}_n X ˉ n σ 2 n ϵ 2 \frac{\sigma^2}{n\epsilon^2} n ϵ 2 σ 2 n n n
下一步的想法是利用所有阶矩的信息,也就是通过矩生成函数 M X ( t ) = E [ e t X ] M_X(t) = \mathbb{E}[e^{tX}] M X ( t ) = E [ e tX ]
Hoeffding's inequality
像"需要多少样本才能以 99% 的把握判断一个动作是次优的"这类问题,按 1 / n 1/n 1/ n r ∈ [ 0 , 1 ] r \in [0, 1] r ∈ [ 0 , 1 ]
设 X 1 , X 2 , … , X n X_1, X_2, \dots, X_n X 1 , X 2 , … , X n X i ∈ [ a i , b i ] X_i \in [a_i, b_i] X i ∈ [ a i , b i ] μ i \mu_i μ i P ( ∑ X i − ∑ μ i ≥ t ) \mathbb{P}(\sum X_i - \sum \mu_i \ge t) P ( ∑ X i − ∑ μ i ≥ t )
切尔诺夫方法
很自然的想法是直接用马尔可夫不等式:
P ( Z ≥ a ) ≤ E [ Z ] a \mathbb{P}(Z \ge a) \le \frac{\mathbb{E}[Z]}{a} P ( Z ≥ a ) ≤ a E [ Z ] 但马尔可夫不等式要求变量非负,而偏差 X i − μ i X_i - \mu_i X i − μ i
E [ ∑ ( X i − μ i ) ] = ∑ ( E [ X i ] − μ i ) = ∑ ( μ i − μ i ) = 0 \mathbb{E}[\sum (X_i - \mu_i)] = \sum (\mathbb{E}[X_i] - \mu_i) = \sum (\mu_i - \mu_i) = 0 E [ ∑ ( X i − μ i )] = ∑ ( E [ X i ] − μ i ) = ∑ ( μ i − μ i ) = 0 P ( ⋯ ≥ t ) ≤ 0 t = 0 \mathbb{P}(\dots \ge t) \le \frac{0}{t} = 0 P ( ⋯ ≥ t ) ≤ t 0 = 0 这显然是错的。解决办法是先套一个单调递增的指数函数。这样变量变成非负的,而且较大的偏差会被放大:
P ( ∑ ( X i − μ i ) ≥ t ) = P ( e s ∑ ( X i − μ i ) ≥ e s t ) \begin{equation}
\mathbb{P}\left(\sum (X_i - \mu_i) \ge t\right) = \mathbb{P}\left(e^{s \sum (X_i - \mu_i)} \ge e^{st}\right)
\end{equation} P ( ∑ ( X i − μ i ) ≥ t ) = P ( e s ∑ ( X i − μ i ) ≥ e s t ) 再用马尔可夫不等式:
P ( ∑ ( X i − μ i ) ≥ t ) ≤ e − s t E [ e s ∑ ( X i − μ i ) ] \begin{equation}
\mathbb{P}\left(\sum (X_i - \mu_i) \ge t\right) \le e^{-st} \mathbb{E}\left[e^{s \sum (X_i - \mu_i)}\right]
\end{equation} P ( ∑ ( X i − μ i ) ≥ t ) ≤ e − s t E [ e s ∑ ( X i − μ i ) ] 由独立性,和的指数的期望等于各项期望的乘积:
P ( … ) ≤ e − s t ∏ i = 1 n E [ e s ( X i − μ i ) ] \begin{equation}
\mathbb{P}(\dots) \le e^{-st} \prod_{i=1}^n \mathbb{E}\left[e^{s(X_i - \mu_i)}\right]
\end{equation} P ( … ) ≤ e − s t i = 1 ∏ n E [ e s ( X i − μ i ) ] 对单个变量写出来,就是切尔诺夫界的一般形式:
P ( X ≥ ϵ ) = P ( e s X ≥ e s ϵ ) ≤ E [ e s X ] e s ϵ = e − s ϵ M X ( s ) \begin{equation}
\mathbb{P}(X \ge \epsilon) = \mathbb{P}(e^{sX} \ge e^{s\epsilon}) \le \frac{\mathbb{E}[e^{sX}]}{e^{s\epsilon}} = e^{-s\epsilon} M_X(s)
\end{equation} P ( X ≥ ϵ ) = P ( e s X ≥ e sϵ ) ≤ e sϵ E [ e s X ] = e − sϵ M X ( s ) 其中 M X ( s ) = E [ e s X ] M_X(s) = \mathbb{E}[e^{sX}] M X ( s ) = E [ e s X ] s s s s s s
霍夫丁引理
要继续推下去,需要给 M X ( s ) M_X(s) M X ( s )
引理 :设 X X X X ∈ [ a , b ] X \in [a, b] X ∈ [ a , b ] s ∈ R s \in \mathbb{R} s ∈ R
E [ e s X ] ≤ e s 2 ( b − a ) 2 8 \begin{equation}
\mathbb{E}[e^{sX}] \le e^{\frac{s^2(b-a)^2}{8}}
\end{equation} E [ e s X ] ≤ e 8 s 2 ( b − a ) 2 证明思路是利用指数函数的凸性。任意 x ∈ [ a , b ] x \in [a, b] x ∈ [ a , b ] a a a b b b
x = b − x b − a a + x − a b − a b \begin{equation}
x = \frac{b-x}{b-a}a + \frac{x-a}{b-a}b
\end{equation} x = b − a b − x a + b − a x − a b 由 e s x e^{sx} e s x
e s x ≤ b − x b − a e s a + x − a b − a e s b \begin{equation}
e^{sx} \le \frac{b-x}{b-a}e^{sa} + \frac{x-a}{b-a}e^{sb}
\end{equation} e s x ≤ b − a b − x e s a + b − a x − a e s b 两边取期望,并利用 E [ X ] = 0 \mathbb{E}[X]=0 E [ X ] = 0
E [ e s X ] ≤ b b − a e s a − a b − a e s b \begin{equation}
\mathbb{E}[e^{sX}] \le \frac{b}{b-a}e^{sa} - \frac{a}{b-a}e^{sb}
\end{equation} E [ e s X ] ≤ b − a b e s a − b − a a e s b 引入两个辅助变量。令 p = − a b − a p = \frac{-a}{b-a} p = b − a − a E [ X ] = 0 \mathbb{E}[X]=0 E [ X ] = 0 a ≤ 0 ≤ b a \le 0 \le b a ≤ 0 ≤ b p ∈ [ 0 , 1 ] p \in [0, 1] p ∈ [ 0 , 1 ] 1 − p = b b − a 1-p = \frac{b}{b-a} 1 − p = b − a b u = s ( b − a ) u = s(b-a) u = s ( b − a )
不等式右边可以写成 u u u
ϕ ( u ) = ( 1 − p ) e − p u + p e ( 1 − p ) u \begin{equation}
\phi(u) = (1-p)e^{-pu} + pe^{(1-p)u}
\end{equation} ϕ ( u ) = ( 1 − p ) e − p u + p e ( 1 − p ) u 目标是证明 ϕ ( u ) ≤ e u 2 / 8 \phi(u) \le e^{u^2/8} ϕ ( u ) ≤ e u 2 /8 L ( u ) = ln ϕ ( u ) L(u) = \ln \phi(u) L ( u ) = ln ϕ ( u ) L ( u ) ≤ u 2 8 L(u) \le \frac{u^2}{8} L ( u ) ≤ 8 u 2
L ( u ) = ln ( ( 1 − p ) e − p u + p e ( 1 − p ) u ) \begin{equation}
L(u) = \ln \left( (1-p)e^{-pu} + pe^{(1-p)u} \right)
\end{equation} L ( u ) = ln ( ( 1 − p ) e − p u + p e ( 1 − p ) u ) 提出 e − p u e^{-pu} e − p u
L ( u ) = − p u + ln ( 1 − p + p e u ) \begin{equation}
L(u) = -pu + \ln \left( 1 - p + pe^u \right)
\end{equation} L ( u ) = − p u + ln ( 1 − p + p e u ) 在 u = 0 u=0 u = 0
L ′ ( u ) = − p + p e u 1 − p + p e u \begin{equation}
L'(u) = -p + \frac{pe^u}{1 - p + pe^u}
\end{equation} L ′ ( u ) = − p + 1 − p + p e u p e u 代入 u = 0 u=0 u = 0 L ′ ( 0 ) = − p + p = 0 L'(0) = -p + p = 0 L ′ ( 0 ) = − p + p = 0
二阶导数:令 q ( u ) = p e u 1 − p + p e u q(u) = \frac{pe^u}{1 - p + pe^u} q ( u ) = 1 − p + p e u p e u L ′ ( u ) = − p + q ( u ) L'(u) = -p + q(u) L ′ ( u ) = − p + q ( u )
L ′ ′ ( u ) = q ′ ( u ) = p e u ( 1 − p + p e u ) − ( p e u ) 2 ( 1 − p + p e u ) 2 = p e u ( 1 − p ) ( 1 − p + p e u ) 2 \begin{equation}
L''(u) = q'(u) = \frac{p e^u (1-p+pe^u) - (pe^u)^2}{(1-p+pe^u)^2} = \frac{pe^u(1-p)}{(1-p+pe^u)^2}
\end{equation} L ′′ ( u ) = q ′ ( u ) = ( 1 − p + p e u ) 2 p e u ( 1 − p + p e u ) − ( p e u ) 2 = ( 1 − p + p e u ) 2 p e u ( 1 − p ) 可以看出 L ′ ′ ( u ) = q ( u ) ( 1 − q ( u ) ) L''(u) = q(u)(1-q(u)) L ′′ ( u ) = q ( u ) ( 1 − q ( u ))
由带拉格朗日余项的泰勒公式,存在介于 0 0 0 u u u ξ \xi ξ
L ( u ) = L ( 0 ) + L ′ ( 0 ) u + 1 2 L ′ ′ ( ξ ) u 2 \begin{equation}
L(u) = L(0) + L'(0)u + \frac{1}{2} L''(\xi)u^2
\end{equation} L ( u ) = L ( 0 ) + L ′ ( 0 ) u + 2 1 L ′′ ( ξ ) u 2 已知 L ( 0 ) = ln ( 1 − p + p ) = 0 L(0) = \ln(1-p+p) = 0 L ( 0 ) = ln ( 1 − p + p ) = 0 L ′ ( 0 ) = 0 L'(0) = 0 L ′ ( 0 ) = 0 z ( 1 − z ) z(1-z) z ( 1 − z ) 1 4 \frac{1}{4} 4 1 z = 1 / 2 z = 1/2 z = 1/2 q ( ξ ) ∈ ( 0 , 1 ) q(\xi) \in (0, 1) q ( ξ ) ∈ ( 0 , 1 )
L ′ ′ ( ξ ) = q ( ξ ) ( 1 − q ( ξ ) ) ≤ 1 4 \begin{equation}
L''(\xi) = q(\xi)(1-q(\xi)) \le \frac{1}{4}
\end{equation} L ′′ ( ξ ) = q ( ξ ) ( 1 − q ( ξ )) ≤ 4 1 代回泰勒展开:
L ( u ) ≤ 0 + 0 + 1 2 ⋅ 1 4 ⋅ u 2 = u 2 8 \begin{equation}
L(u) \le 0 + 0 + \frac{1}{2} \cdot \frac{1}{4} \cdot u^2 = \frac{u^2}{8}
\end{equation} L ( u ) ≤ 0 + 0 + 2 1 ⋅ 4 1 ⋅ u 2 = 8 u 2 把 u = s ( b − a ) u = s(b-a) u = s ( b − a )
ln ( E [ e s X ] ) ≤ L ( s ( b − a ) ) ≤ s 2 ( b − a ) 2 8 \begin{equation}
\ln(\mathbb{E}[e^{sX}]) \le L(s(b-a)) \le \frac{s^2(b-a)^2}{8}
\end{equation} ln ( E [ e s X ]) ≤ L ( s ( b − a )) ≤ 8 s 2 ( b − a ) 2 两边取指数,就是霍夫丁引理:
E [ e s X ] ≤ exp ( s 2 ( b − a ) 2 8 ) \begin{equation}
\mathbb{E}[e^{sX}] \le \exp\left( \frac{s^2(b-a)^2}{8} \right)
\end{equation} E [ e s X ] ≤ exp ( 8 s 2 ( b − a ) 2 ) 右边恰好是方差为 ( b − a ) 2 4 \frac{(b-a)^2}{4} 4 ( b − a ) 2 [ a , b ] [a, b] [ a , b ] ( b − a ) 2 4 \frac{(b-a)^2}{4} 4 ( b − a ) 2 1 / 8 1/8 1/8 1 / 2 1/2 1/2 z ( 1 − z ) z(1-z) z ( 1 − z ) 1 / 4 1/4 1/4
霍夫丁不等式
把霍夫丁引理代入切尔诺夫界。设 X 1 , … , X n X_1, \dots, X_n X 1 , … , X n μ \mu μ [ a , b ] [a, b] [ a , b ] X ˉ n = 1 n ∑ X i \bar{X}_n = \frac{1}{n} \sum X_i X ˉ n = n 1 ∑ X i s s s s = 4 n ϵ ( b − a ) 2 s = \frac{4n\epsilon}{(b-a)^2} s = ( b − a ) 2 4 n ϵ
P ( X ˉ n − μ ≥ ϵ ) ≤ exp ( − 2 n ϵ 2 ( b − a ) 2 ) \begin{equation}
\mathbb{P}(\bar{X}_n - \mu \ge \epsilon) \le \exp\left( - \frac{2n\epsilon^2}{(b-a)^2} \right)
\end{equation} P ( X ˉ n − μ ≥ ϵ ) ≤ exp ( − ( b − a ) 2 2 n ϵ 2 ) 这个结果有两个直接的推论。
第一,误差概率随样本数 n n n ( b − a ) 2 ln 10 2 ϵ 2 \frac{(b-a)^2 \ln 10}{2\epsilon^2} 2 ϵ 2 ( b − a ) 2 l n 10
第二,可以反过来求置信区间。取 [ a , b ] = [ 0 , 1 ] [a, b] = [0, 1] [ a , b ] = [ 0 , 1 ] δ \delta δ exp ( − 2 n ϵ 2 ) = δ \exp(-2n\epsilon^2) = \delta exp ( − 2 n ϵ 2 ) = δ
ϵ = ln ( 1 / δ ) 2 n \begin{equation}
\epsilon = \sqrt{\frac{\ln(1/\delta)}{2n}}
\end{equation} ϵ = 2 n ln ( 1/ δ ) 也就是说,以至少 1 − δ 1-\delta 1 − δ ϵ \epsilon ϵ ln t / n \sqrt{\ln t / n} ln t / n
Mathematical derivation of the UCB algorithm
有了霍夫丁不等式,就可以定量处理探索与利用(Exploration vs. Exploitation)的问题。如果只用贪心策略,智能体可能一直选当前估计最好的动作,而从未充分尝试真正更好的动作。
下面以多臂老虎机(Multi-Armed Bandit, MAB)为例,说明霍夫丁不等式如何给出 UCB(Upper Confidence Bound)算法。
Optimism in the Face of Uncertainty
UCB 的原则是"面对不确定性保持乐观"。一个动作的真实期望 μ a \mu_a μ a μ ^ a \hat{\mu}_a μ ^ a U t ( a ) U_t(a) U t ( a )
μ a ≤ μ ^ a ( t ) + U t ( a ) \begin{equation}
\mu_a \le \hat{\mu}_a(t) + U_t(a)
\end{equation} μ a ≤ μ ^ a ( t ) + U t ( a ) 然后每一步选择这个置信上限最高的动作。
从霍夫丁不等式推出 UCB
设动作 a a a t t t N t ( a ) N_t(a) N t ( a ) [ 0 , 1 ] [0, 1] [ 0 , 1 ]
P ( μ a ≥ μ ^ a ( t ) + ϵ t ) ≤ exp ( − 2 N t ( a ) ϵ t 2 ) \mathbb{P}\left( \mu_a \ge \hat{\mu}_a(t) + \epsilon_t \right) \le \exp\left( -2 N_t(a) \epsilon_t^2 \right) P ( μ a ≥ μ ^ a ( t ) + ϵ t ) ≤ exp ( − 2 N t ( a ) ϵ t 2 ) 令 δ t \delta_t δ t
exp ( − 2 N t ( a ) ϵ t 2 ) = δ t \begin{equation}
\exp\left( -2 N_t(a) \epsilon_t^2 \right) = \delta_t
\end{equation} exp ( − 2 N t ( a ) ϵ t 2 ) = δ t 取对数解出 ϵ t \epsilon_t ϵ t
− 2 N t ( a ) ϵ t 2 = ln ( δ t ) ⟹ ϵ t = − ln ( δ t ) 2 N t ( a ) \begin{equation}
-2 N_t(a) \epsilon_t^2 = \ln(\delta_t) \implies \epsilon_t = \sqrt{\frac{-\ln(\delta_t)}{2 N_t(a)}}
\end{equation} − 2 N t ( a ) ϵ t 2 = ln ( δ t ) ⟹ ϵ t = 2 N t ( a ) − ln ( δ t ) 随着步数 t t t δ t \delta_t δ t δ t = t − 4 \delta_t = t^{-4} δ t = t − 4 ln t \ln t ln t
ϵ t = − ln ( t − 4 ) 2 N t ( a ) = 4 ln t 2 N t ( a ) = 2 ln t N t ( a ) \begin{equation}
\epsilon_t = \sqrt{\frac{-\ln(t^{-4})}{2 N_t(a)}} = \sqrt{\frac{4 \ln t}{2 N_t(a)}} = \sqrt{\frac{2 \ln t}{N_t(a)}}
\end{equation} ϵ t = 2 N t ( a ) − ln ( t − 4 ) = 2 N t ( a ) 4 ln t = N t ( a ) 2 ln t 于是得到 UCB 的选择规则:
A t = arg max a ∈ A [ Q ^ t ( a ) + c ln t N t ( a ) ] \begin{equation}
A_t = \arg\max_{a \in \mathcal{A}} \left[ \hat{Q}_t(a) + c \sqrt{\frac{\ln t}{N_t(a)}} \right]
\end{equation} A t = arg a ∈ A max [ Q ^ t ( a ) + c N t ( a ) ln t ] 其中 c = 2 c = \sqrt{2} c = 2 c c c
Temporal difference learning and the bootstrapping principle
霍夫丁不等式给样本均值划定了置信范围。但蒙特卡罗(MC)方法有一个结构上的问题:它要用完整轨迹的回报 G t G_t G t G t G_t G t R t + k R_{t+k} R t + k
要绕开这一点,需要回到贝尔曼方程的递推结构。MC 是对整条路径求平均,而时序差分(Temporal Difference, TD)学习每一步只看一次转移,用下一状态的估计值来更新当前状态。
自举与 TD 误差
TD 的核心是自举(bootstrapping):用后续状态的估计值更新当前状态的估计值。它直接来自贝尔曼期望方程:
V π ( s ) = E π [ R t + 1 + γ V π ( S t + 1 ) ∣ S t = s ] V^\pi(s) = \mathbb{E}_\pi [R_{t+1} + \gamma V^\pi(S_{t+1}) \mid S_t = s] V π ( s ) = E π [ R t + 1 + γ V π ( S t + 1 ) ∣ S t = s ] 在无模型的设定下,我们无法计算这个期望,但每次真实转移 ( S t , A t , R t + 1 , S t + 1 ) (S_t, A_t, R_{t+1}, S_{t+1}) ( S t , A t , R t + 1 , S t + 1 ) G t T D = R t + 1 + γ V ( S t + 1 ) G_t^{TD} = R_{t+1} + \gamma V(S_{t+1}) G t T D = R t + 1 + γ V ( S t + 1 ) V ( S t + 1 ) V(S_{t+1}) V ( S t + 1 )
TD 误差 δ t \delta_t δ t
δ t = R t + 1 + γ V ( S t + 1 ) − V ( S t ) \begin{equation}
\delta_t = R_{t+1} + \gamma V(S_{t+1}) - V(S_t)
\end{equation} δ t = R t + 1 + γ V ( S t + 1 ) − V ( S t ) 按随机逼近(stochastic approximation)的思路更新:
V ( S t ) ← V ( S t ) + α δ t \begin{equation}
V(S_t) \leftarrow V(S_t) + \alpha \delta_t
\end{equation} V ( S t ) ← V ( S t ) + α δ t α \alpha α δ t 2 \delta_t^2 δ t 2 V ( S t + 1 ) V(S_{t+1}) V ( S t + 1 )
偏差与方差
自举改变了估计量的性质,这就是强化学习中常说的偏差-方差权衡。MC 的目标 G t = ∑ γ k R t + k + 1 G_t = \sum \gamma^k R_{t+k+1} G t = ∑ γ k R t + k + 1 V π ( s ) V^\pi(s) V π ( s )
TD 目标 R t + 1 + γ V ( S t + 1 ) R_{t+1} + \gamma V(S_{t+1}) R t + 1 + γ V ( S t + 1 )
方差低:它只受一步随机性(R t + 1 R_{t+1} R t + 1 S t + 1 S_{t+1} S t + 1 V ( S t + 1 ) V(S_{t+1}) V ( S t + 1 )
有偏:学习初期 V ( S t + 1 ) V(S_{t+1}) V ( S t + 1 )
换句话说,TD 用一部分偏差换来了方差的大幅下降。这解释了为什么实践中 TD 方法通常比 MC 有更好的样本效率。
收敛性
对有限状态 MDP,在学习率满足常规条件时,表格型 TD(0) 以概率 1 收敛到 V π V^\pi V π
在固定的一批数据上反复做 TD(0) 更新(batch TD),结果会收敛到确定性等价(certainty-equivalence)估计:先用数据估计出最大似然的 MDP 模型(转移概率和奖励),再精确求解这个模型下的价值函数。批量 MC 则收敛到使训练回报均方误差最小的估计。这是两者在同样数据上给出不同答案的原因。
从单步到多步
TD(0) 只看一步,MC 看到回合结束,两者之间是 n 步时序差分(n-step TD):
G t : t + n = R t + 1 + γ R t + 2 + ⋯ + γ n − 1 R t + n + γ n V ( S t + n ) \begin{equation}
G_{t:t+n} = R_{t+1} + \gamma R_{t+2} + \dots + \gamma^{n-1} R_{t+n} + \gamma^n V(S_{t+n})
\end{equation} G t : t + n = R t + 1 + γ R t + 2 + ⋯ + γ n − 1 R t + n + γ n V ( S t + n ) n n n λ \lambda λ
回头看整条线:模型已知时,贝尔曼算子的压缩性保证价值迭代收敛;模型未知时,集中不等式告诉我们有限样本的估计能有多准,UCB 用它来指导探索,TD 则用自举在偏差和方差之间取舍。